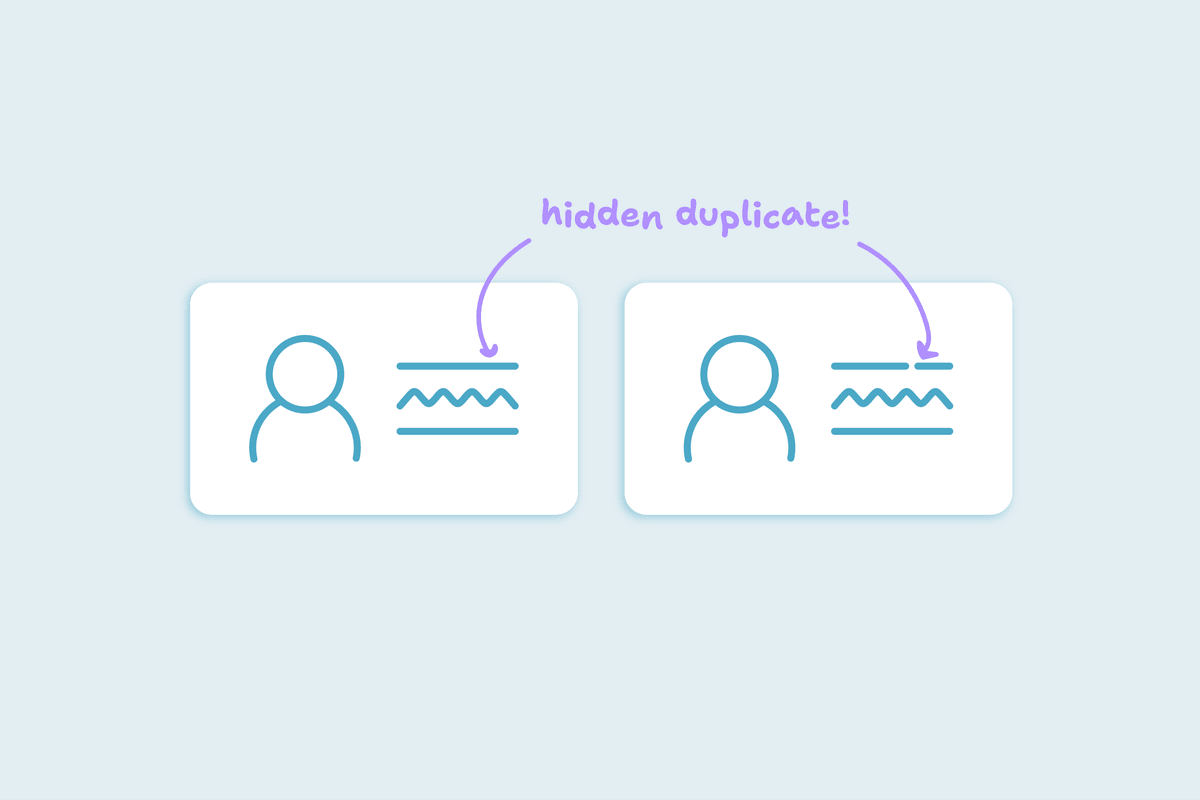


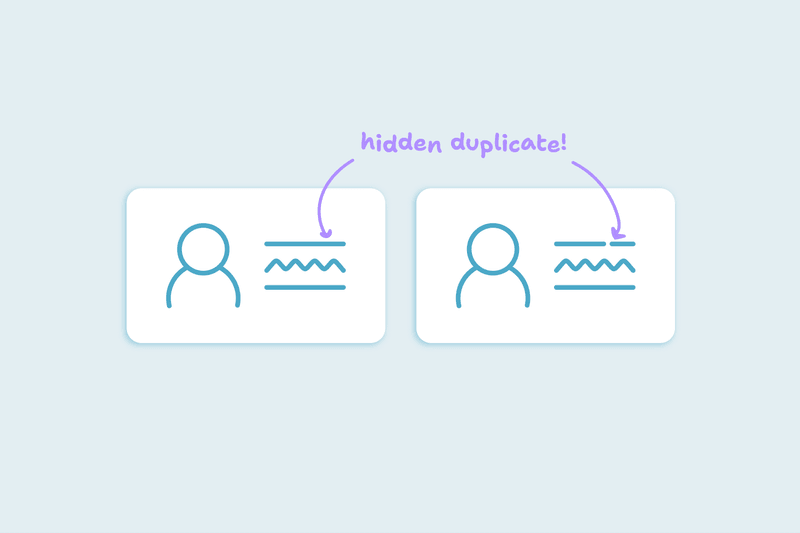
De flesta CRM-användare tror att dubbletter är lätta att se: samma e-post, samma telefon, samma företagsnamn. Men så tydliga är de sällan; de göms bakom stavningsvarianter, olika format och tomma fält - och fångar du dem inte redan vid matchningen blir varje sammanslagning som följer riskabel.
Guiden visar hur du identifierar dubbletter med säkerhet. Du får veta skillnaden mellan uppenbara och dolda dubbletter, vilka fält som är mest pålitliga, hur matchningsalternativen fungerar och hur du testar din uppsättning innan du automatiserar.
Vad skiljer uppenbara och dolda dubbletter?
- Uppenbara dubbletter är enkla: två poster med samma e-postadress, telefonnummer eller domän. De kan matchas tryggt och slås ihop utan tvekan.
- Dolda dubbletter är knepigare:
- “Chris Johnson” vs “Christopher Johnson”
- “Brightline Technologies” vs “Bright Line Tech”
- En post har en jobbadress, en annan ett mobilnummer – båda tillhör samma person
Uppenbara dubbletter är ovanliga. Det är de dolda dubbletterna som tar mest tid att rensa, och där matchningslogiken betyder mest.
Vilka fält är mest tillförlitliga för att hitta dubbletter?
Även om vissa fält är starka identifierare rekommenderar vi att du kombinerar minst två.
- Stark i kombination:
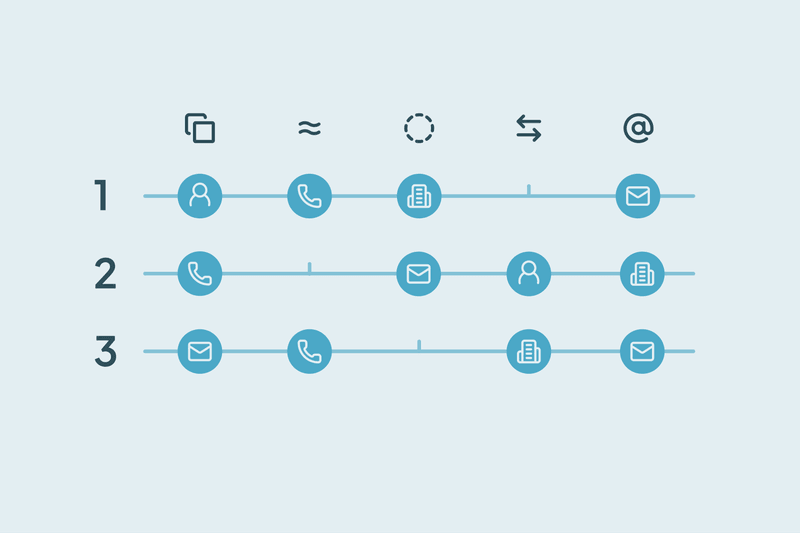
- Förnamn + Efternamn + E-post
- Företagsnamn + Adress + Postnummer
- Förnamn + Efternamn + Telefon
- Opålitliga fält:
- Befattning
- Anteckningar
- Fritextfält
Vilka matchningsalternativ är säkrast att börja med?
I Dedupely väljer du matchningsalternativ för varje fält du förlitar dig på, så att du kan avgöra vad som är en dubblett. Tillgängliga matchningsalternativ:
- Exakt matchning: Fälten måste matcha exakt
- Liknande matchning: Fångar små stavningsskillnader.
- Fuzzy matchning: Hittar närliggande varianter, till exempel ”Chris” och ”Christopher”.
- Matchning med Similar Words (valfri ordning): Hittar matchningar där orden är omkastade (t.ex. “Brightline Technologies” vs “Technologies Brightline”).
- Domänrotsmatchning: Tar bort subdomäner och matchar på huvuddomänen (t.ex. “mail.greenfield.io” vs “greenfield.io”).
Bästa praxis:
- Börja med exakt matchning på Förnamn + Efternamn + E-post
- Lägg till Similar/Fuzzy för namn och företagsnamn när du testat träffsäkerheten.
- Använd domänrot för företag så fångar du formatskillnader.
Du kan spara dem i Search Pads och återanvända dem. Då slipper du bygga om logiken varje gång.
Hur testar jag min matchning för att undvika falska positiva och negativa träffar?
Matchningslogiken behöver testas innan du kan lita på den i stor skala. Här är ett enkelt arbetssätt:
- Kör en skanning med de matchningsinställningar du valt.
- Granska 5–10 matchade par manuellt.
- Markera vilka som är verkliga dubbletter och vilka som är felmatchningar.
- Om felaktiga matchningar dyker upp, skärp tröskelvärdena eller lägg till fler fält.
- Kör om skanningen tills resultatet är stabilt och korrekt.
- När du är nöjd sparar du logiken som en Search Pad för återanvändning.
Tester förebygger två vanliga risker: att av misstag slå ihop olika personer (falska positiva) och att missa dubbletter helt (falska negativa).
Bra matchningar är grunden för säkra sammanslagningar
Dubbletthantering börjar med matchning, och utan stark matchningslogik blir sammanslagningarna antingen osäkra eller ofullständiga.
Med tillförlitliga fält, rätt matchningsalternativ och ett testat upplägg hittar du verkliga dubbletter konsekvent. Search Pads låter dig sedan upprepa processen utan att börja om.

 Eller registrera dig med Google

 HubSpot-användare
 Dedupely Intelligence