

Att slå ihop i en CSV är inte som att slå ihop i ett CRM. Det finns inga inbyggda logikregler, inga inbyggda kopplingar och ingen förvald ”primär” post. I stället avgörs beteendet av en enda sak: radposition.
I Dedupely översta raden i varje matchningsgrupp vinner. Den radens värden behålls, om ingen Merge Rule säger annat. Du ser hela resultatet innan sammanslagningen sker – ingen automatik i bakgrunden, inga överraskningar.
Det gör också CSV-läget perfekt för test. Du kan bygga en Search Pad, förhandsgranska hur sammanslagningar beter sig och köra om matchningar utan att röra aktiva CRM-data. Fungerar en regel behåller du den. Annars justerar du och testar igen.
Alla kärnverktyg ingår: merge rules, massmerge, auto merge, search pads och egen matchningslogik. Du får dessutom ett nedladdningsbart huvudark med alla sammanslagna poster, redo för uppladdning eller överlämning.
Största hindret? Filformatet. Om rubrikerna inte stämmer överens eller värdena hamnar fel mellan kolumnerna blir resultatet inte rent. Men med rätt struktur ger CSV ett snabbt och förutsägbart sätt att testa och skala din dedupliceringslogik, innan den når ditt CRM.
Så slår du ihop dubbletter i en CSV med Dedupely:
- Ladda upp din CSV-fil till Dedupely
- Se till att filen är ren och konsekvent strukturerad: kolumnrubrikerna måste matcha i alla rader
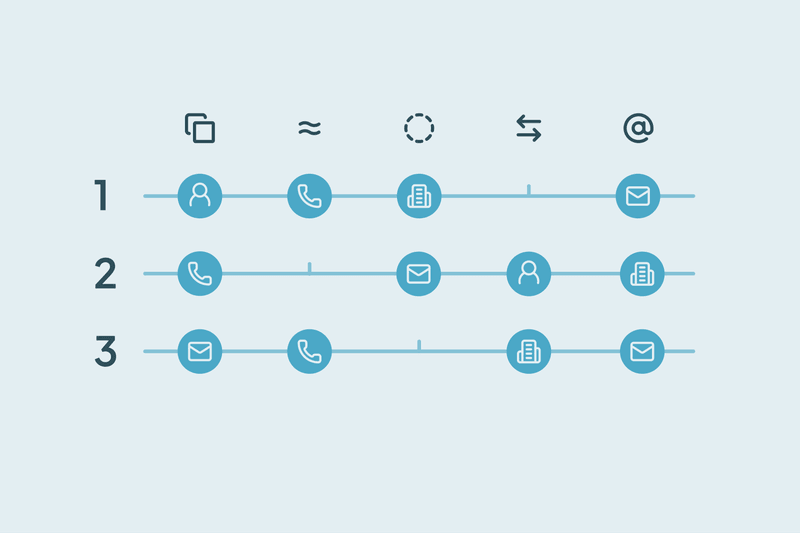
- Ställ in matchningsregler för att hitta dubbletter
- Justera översta raden i varje matchgrupp – den raden bestämmer slutvärdena
- Använd merge rules på redigerbara fält vid behov
- Exportera ett rensat huvudark att använda eller importera
Sammanslagning via CSV ger full kontroll, oavsett om du testar logik innan du synkar eller städar en fristående datamängd. Du får redigerbar kontroll, tydliga förhandsvisningar och konsekventa resultat. Inget CRM krävs. Bara en strukturerad fil, smarta regler och en process som går att upprepa.
För en mer detaljerad genomgång, den här guiden går igenom vår CSV-sammanslagning steg för steg.

 Eller registrera dig med Google


 Dedupely Intelligence